Le fichier robots.txt est un petit fichier texte qui peut avoir de grandes conséquences sur l’exploration d’un site. Une règle trop large suffit parfois à empêcher Googlebot ou un autre robot d’accéder à des pages importantes, à leurs images ou aux fichiers nécessaires à leur affichage. À l’inverse, interdire quelques URLs inutiles peut aider à limiter le crawl de zones qui n’apportent rien à la recherche.
La bonne approche n’est donc pas de bloquer un maximum de répertoires. Il faut d’abord comprendre ce que les robots explorent, puis définir des règles ciblées et les tester avant publication. Ce guide explique comment fonctionne robots.txt en SEO, ce qu’il ne peut pas faire et comment réduire le risque d’une erreur coûteuse, que votre site soit un blog, un site marchand ou une plateforme plus complexe.
À quoi sert robots.txt en SEO ?
robots.txt indique aux robots conformes aux règles du protocole quelles parties d’un site ils peuvent explorer ou non. Il agit comme une consigne de crawl, pas comme un verrou technique. Un robot qui respecte les règles peut choisir de ne pas demander les URL interdites ; le fichier ne supprime toutefois ni la page ni son contenu.
Une règle comme Disallow: /recherche/ peut, par exemple, limiter l’exploration des pages de résultats internes. Elle ne protège pas ces pages contre l’accès des internautes et n’empêche pas nécessairement une URL d’apparaître dans un moteur. Si d’autres pages font un lien vers une URL bloquée, le moteur peut connaître son existence et éventuellement afficher l’adresse sans en avoir exploré le contenu.
Le fichier est particulièrement utile pour éviter l’exploration de zones sans intérêt pour les moteurs, comme certaines combinaisons de filtres ou des espaces de navigation générés en masse. Il peut aussi aider à préserver des ressources de crawl sur les sites très volumineux. Pour un petit site, il n’est pas forcément nécessaire de multiplier les règles : un fichier simple, voire une politique qui autorise tout le site, peut être le choix le plus sûr.
Ce que robots.txt ne fait pas
Confondre crawl, indexation et confidentialité est une source fréquente d’erreurs. Les notions sont liées, mais elles ne désignent pas le même processus.
- Le crawl correspond à la récupération d’une URL par un robot.
- L’indexation correspond à l’analyse et à l’éventuelle conservation d’une page dans l’index d’un moteur.
- La confidentialité consiste à empêcher les personnes non autorisées d’accéder à une ressource.
robots.txt peut demander à un robot de ne pas explorer une URL. Il ne garantit pas que celle-ci ne sera pas indexée. Il ne doit jamais servir à protéger des données sensibles, un espace client, un fichier privé ou un environnement de préproduction. Pour ces usages, utilisez une authentification et des contrôles d’accès côté serveur.
Si une page doit rester accessible aux moteurs, mais ne pas figurer dans les résultats, une directive d’indexation telle que noindex peut convenir. Pour que le robot lise cette directive, il doit pouvoir accéder à la page : l’interdire dans robots.txt empêche justement cette lecture. Pour une ressource qui ne doit pas être publique, la bonne solution est de restreindre l’accès, pas de compter sur son absence dans un fichier public.
Où placer le fichier et à quel site s’applique-t-il ?
Le fichier doit se trouver à la racine de l’hôte concerné. Pour https://exemple.com, son adresse habituelle est https://exemple.com/robots.txt. Un fichier placé dans /blog/robots.txt ne définit pas les règles de l’ensemble du domaine.
Les règles s’appliquent à l’origine précise du fichier : protocole, hôte et port. Ainsi, https://exemple.com, http://exemple.com et https://www.exemple.com sont des origines différentes. Un sous-domaine tel que shop.exemple.com a besoin de son propre fichier s’il doit recevoir des consignes particulières. Vérifiez donc chaque version réellement accessible, surtout lors d’une migration ou d’une configuration avec plusieurs sous-domaines.
Le fichier doit être servi à l’adresse attendue, idéalement avec une réponse HTTP 200 et un contenu texte UTF-8. Évitez de le remplacer par une page HTML, une page de consentement ou une redirection complexe. Les moteurs savent gérer certains cas d’erreur et de redirection, mais un accès direct et stable réduit l’ambiguïté. Après une modification, contrôlez la réponse depuis le navigateur ou avec un outil de diagnostic HTTP.
Lire et écrire les principales directives
Une règle classique associe un groupe de robots à une ou plusieurs consignes. User-agent désigne le robot visé ; Disallow interdit l’exploration d’un chemin ; Allow, pris en charge par les grands moteurs, permet une exception. Les directives sont généralement écrites une par ligne.
User-agent: *
Disallow: /espace-prive/
Allow: /espace-prive/aide-publique/
Ici, le groupe s’applique à tous les robots qui respectent la consigne. La zone /espace-prive/ est interdite, avec une exception pour le chemin /espace-prive/aide-publique/. Cette règle ne remplace pas un contrôle d’accès : le nom « privé » ne rend pas le contenu confidentiel.
Un fichier vide, ou un groupe comportant Disallow: sans chemin, indique généralement qu’aucun chemin n’est interdit à ce groupe. Pour autoriser explicitement l’exploration générale, on peut écrire :
User-agent: *
Disallow:
Les chemins doivent être choisis avec précision. Une règle visant /panier/ ne devrait pas être remplacée par une interdiction générale de /, qui bloquerait l’ensemble du site. Sur les moteurs qui reconnaissent les caractères génériques, * peut représenter une suite de caractères et $ la fin d’un chemin. Leur interprétation peut dépendre du robot : testez la règle avec le moteur visé plutôt que de supposer que tous les robots la comprennent de la même manière.
Les directives propres à un robot et les directives générales doivent être organisées avec soin. Si vous ajoutez plusieurs groupes, vérifiez à quel groupe chaque ligne appartient. Une règle placée après un nouveau User-agent ne s’applique pas automatiquement au groupe précédent. La syntaxe peut être tolérante, mais un fichier facile à lire est plus simple à auditer et à maintenir.
Vous pouvez également indiquer un plan de site XML avec une ligne Sitemap: et une URL absolue :
Sitemap: https://exemple.com/sitemap.xml
Cette ligne ne donne pas accès aux URL bloquées et ne remplace pas la soumission ou la découverte du sitemap par d’autres moyens. Elle fournit simplement une indication utile aux robots qui la prennent en charge.
Choisir quoi bloquer sans nuire au référencement
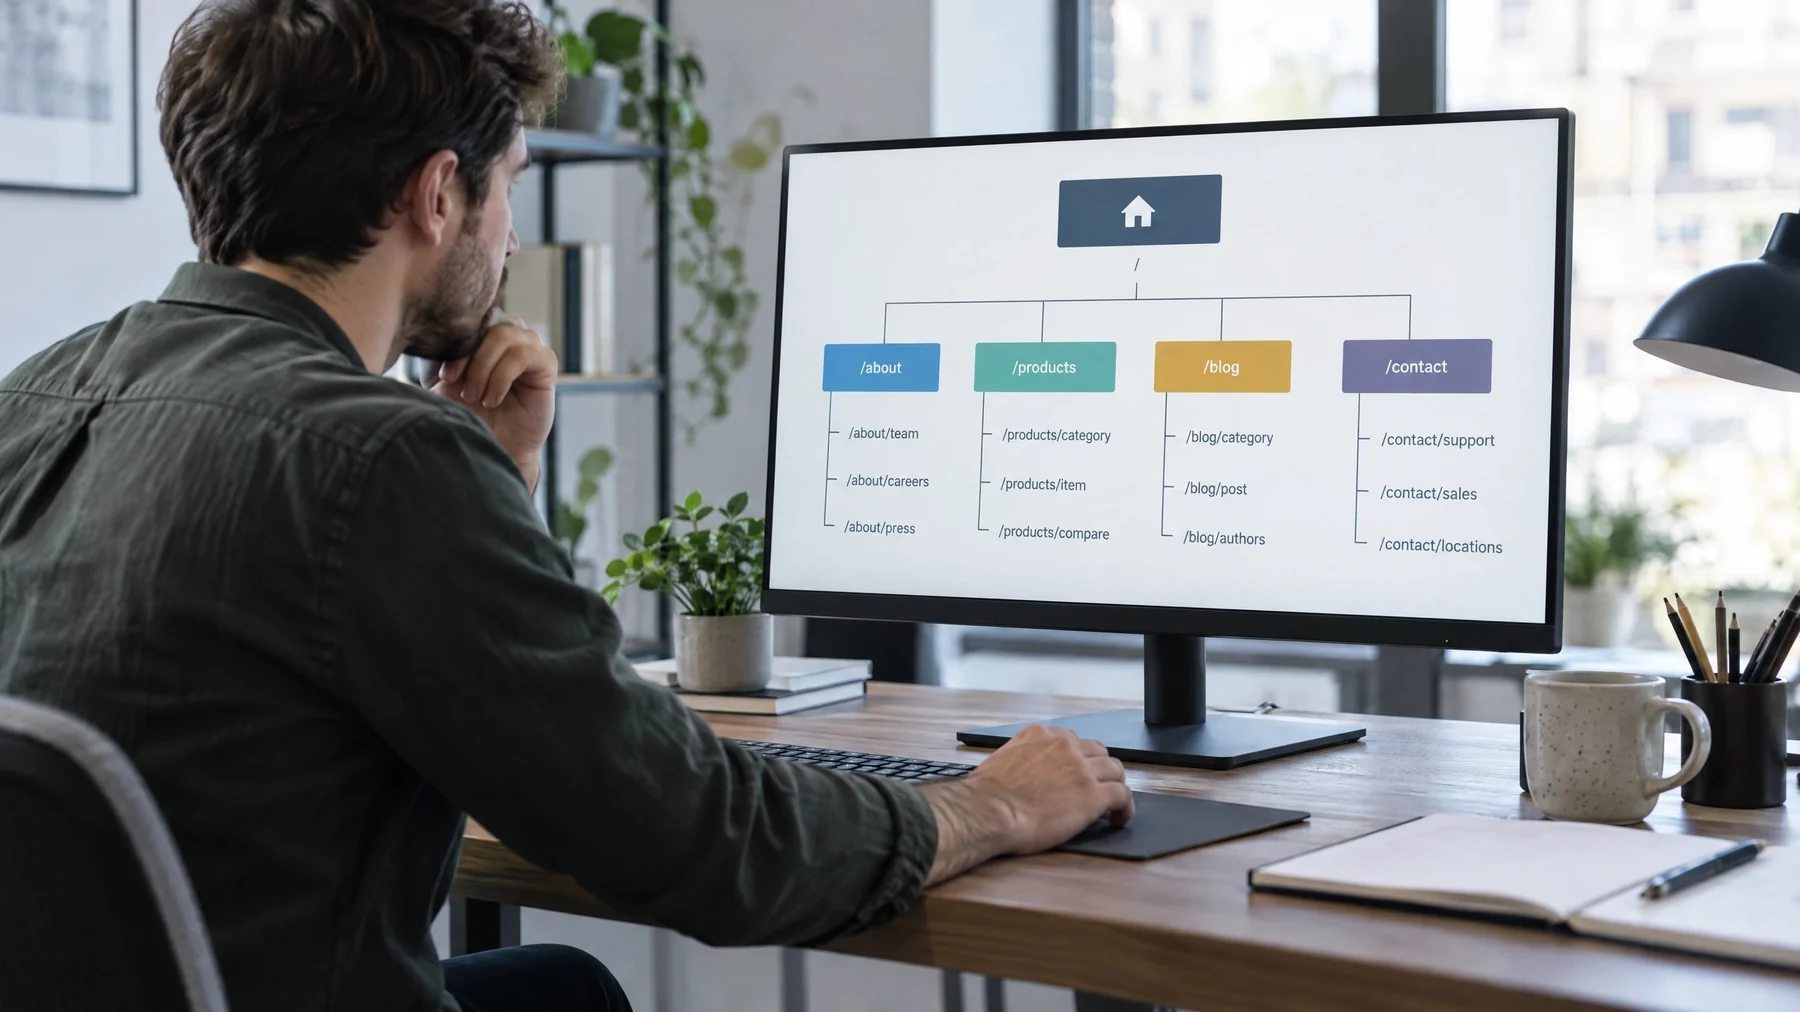
Ne partez pas d’une liste trouvée sur un autre site ou d’un modèle généré automatiquement. Deux sites utilisant le même CMS peuvent avoir des structures et des besoins très différents. Commencez par relever les zones qui génèrent des URLs, puis demandez-vous si leur exploration présente un intérêt pour les internautes et les moteurs.
Les recherches internes, les combinaisons de filtres, certains calendriers ou des paramètres de tri peuvent créer de nombreuses variantes d’une même page. Sur un site marchand, plusieurs filtres combinés peuvent aussi produire une quantité importante d’URLs. Il peut être pertinent d’en limiter le crawl lorsque ces pages n’ont pas de valeur de recherche et ne doivent pas être explorées. Mais certaines pages de catégorie filtrées correspondent à une demande réelle et méritent d’être accessibles. Décidez selon leur utilité, leur contenu, leur maillage et leur stratégie d’indexation, pas uniquement selon la présence d’un paramètre dans l’URL.
Ne bloquez pas par réflexe les fichiers CSS, JavaScript ou les images nécessaires au rendu des pages. Les moteurs peuvent s’appuyer sur ces ressources pour comprendre l’affichage et l’expérience d’une page. Si une règle existante les interdit, vérifiez concrètement le rendu dans les outils de diagnostic avant de la conserver.
Les répertoires d’administration sont parfois bloqués par précaution, mais robots.txt est public : n’importe qui peut le consulter. Une consigne qui révèle l’emplacement d’une zone n’en assure pas la sécurité. Dans la mesure où une page d’administration exige déjà une authentification, la règle de crawl est souvent secondaire.
Une méthode concrète en six étapes
Pour limiter les erreurs, traitez le fichier comme une configuration à auditer, pas comme une formalité de lancement.
- Inventoriez les hôtes. Listez les domaines, sous-domaines, protocoles et environnements concernés. Repérez les versions historiques encore accessibles et les hôtes qui redirigent.
- Récupérez le fichier actuel. Consultez directement chaque
robots.txt et notez les règles en place. Comparez-les avec les paramètres du CMS, du serveur et du CDN : plusieurs systèmes peuvent intervenir dans la réponse finale.
- Cartographiez les URLs. Utilisez les journaux serveur, les outils d’exploration et les données de Search Console pour identifier les sections explorées, les erreurs récurrentes et les pages utiles. Les journaux aident à distinguer le passage réel des robots des hypothèses de configuration.
- Formulez un objectif par règle. Par exemple : limiter l’exploration des résultats de recherche interne, sans bloquer les pages d’aide accessibles depuis ces résultats. Si vous ne pouvez pas expliquer l’effet attendu d’une règle, ne l’ajoutez pas encore.
- Testez des exemples représentatifs. Vérifiez au minimum une URL qui doit être autorisée, une qui doit être bloquée et les exceptions proches. Testez aussi les variantes avec et sans barre oblique finale, et les ressources nécessaires au rendu.
- Publiez puis contrôlez. Après le déploiement, ouvrez le fichier à son adresse publique, vérifiez son statut HTTP et retestez les URL critiques. Conservez une copie de l’ancienne version pour pouvoir revenir rapidement en arrière.
Cette méthode fonctionne aussi pour une petite mise à jour. Une modification d’une seule ligne peut changer le comportement de robots sur des milliers d’URLs si le chemin est trop large.
Cas fréquents : facettes, paramètres et environnements de test
Sur un site à facettes, bloquez seulement après avoir séparé les variantes utiles des combinaisons sans valeur. Par exemple, une page filtrée sur une catégorie et une caractéristique recherchée peut apporter une réponse pertinente ; une URL combinant plusieurs dizaines de filtres peut être un cul-de-sac. La règle doit correspondre à la structure réelle des chemins et paramètres. Il faut la tester sur des URL représentatives, car une expression trop générale peut interdire des pages de catégorie importantes.
Pour les paramètres de suivi, commencez par vérifier s’ils créent réellement un problème de crawl ou de duplication. Les moteurs savent souvent traiter des variantes, et d’autres mécanismes du site peuvent préciser la version préférée. Une interdiction indiscriminée de tout chemin contenant un point d’interrogation risque de bloquer des fonctionnalités ou des pages utiles. Évitez les règles complexes tant que vous n’avez pas établi leur effet précis.
Les environnements de préproduction doivent être protégés par une authentification ou une restriction réseau. Ajouter Disallow: / au fichier de test peut fournir une précaution supplémentaire pour les robots conformes, mais ce n’est pas une barrière de sécurité. Lors d’une mise en production, vérifiez que le fichier de test n’a pas été copié tel quel : c’est une cause classique de site entièrement bloqué.
Tester et diagnostiquer robots.txt
Un contrôle fiable combine plusieurs méthodes. La lecture manuelle permet de repérer une règle générale ; un outil de test aide à vérifier comment un moteur donné interprète un chemin ; l’inspection des URL et des journaux confirme ensuite le comportement observé. Aucun outil ne prouve à lui seul que toutes les versions du site sont correctement configurées.
Dans Google Search Console, inspectez les pages importantes et vérifiez si Google peut les explorer. Examinez aussi les rapports d’indexation et les éventuels avertissements liés au fichier. Pour un diagnostic technique, utilisez un outil de test compatible avec le robot concerné, puis confrontez son résultat aux règles publiées sur le véritable domaine. Un fichier de test local ou une ancienne version ne reflète pas forcément ce que reçoit Googlebot.
Quand une page attendue n’est pas visible dans les résultats, posez les questions dans cet ordre : le serveur répond-il correctement ? Le robot peut-il accéder à l’URL ? La page porte-t-elle une directive noindex ? Le contenu est-il réellement utile et découvrable par des liens ? Les canonicals et les redirections sont-ils cohérents ? robots.txt n’est qu’une piste parmi d’autres.
Surveillez enfin les changements après une mise à jour : les URL importantes restent-elles accessibles, les erreurs de crawl diminuent-elles, de nouvelles familles d’URL apparaissent-elles ? Un blocage ne doit pas être jugé uniquement au nombre de lignes du fichier. Le résultat dépend du site, des robots et de la manière dont les pages sont reliées entre elles.
Erreurs à éviter
- Bloquer tout le site sans s’en rendre compte. Une ligne
Disallow: / dans le mauvais groupe peut empêcher l’exploration générale. Vérifiez en priorité cette règle sur chaque hôte.
- Utiliser
robots.txt pour demander une désindexation. Une page interdite peut rester connue. Utilisez le mécanisme adapté à l’objectif et laissez le robot accéder à la page lorsqu’il doit lire une directive d’indexation.
- Bloquer les ressources de rendu. Une page accessible mais privée de ses fichiers CSS ou JavaScript peut être comprise de façon incomplète.
- Copier les règles d’un autre site. Un modèle peut bloquer des répertoires propres à votre CMS ou à vos pages commerciales.
- Traiter le fichier comme un contrôle de sécurité. Les robots conformes ne sont pas les seuls acteurs du Web ; les autres ne sont pas tenus de respecter ces consignes.
- Oublier les sous-domaines et les mises en production. La configuration de
www ne couvre pas automatiquement celle de shop, et un fichier de préproduction peut bloquer le domaine final.
- Ajouter des directives non prises en charge.
Crawl-delay n’est pas une consigne Google. Son comportement dépend du robot ; ne comptez pas dessus sans vérifier la documentation du moteur visé.
Checklist avant et après publication
Avant le déploiement, confirmez que :
- le fichier est bien à la racine de chaque hôte concerné et répond sans erreur ;
- chaque règle a un objectif identifié et ne bloque pas une section utile ;
- les pages stratégiques et leurs ressources de rendu restent accessibles ;
- les exceptions
Allow sont testées avec les interdictions voisines ;
- les consignes ne sont pas utilisées pour protéger des informations confidentielles ;
- le sitemap indiqué est une URL absolue et correspond au bon domaine ;
- les équipes SEO, développement et sécurité comprennent les effets attendus.
Après publication, vérifiez le fichier public, testez des URL autorisées et interdites, inspectez les pages prioritaires, puis surveillez les journaux et les rapports de crawl. Notez la date, la raison du changement et la personne responsable. Cette petite trace facilite le diagnostic si une page disparaît ou si un robot se comporte différemment de ce qui était prévu.
Questions fréquentes
Un robots.txt est-il obligatoire ?
Non. Un site peut être exploré sans fichier, selon les liens découverts et les autres signaux disponibles. Créer un fichier est utile pour exprimer des consignes ; il n’est pas nécessaire d’y ajouter des interdictions si aucune n’est justifiée.
Une URL bloquée dans robots.txt peut-elle apparaître dans Google ?
Oui, c’est possible. Google peut connaître l’URL par des liens ou d’autres indications sans avoir pu en explorer le contenu. Le fichier ne garantit donc pas la désindexation. Si l’objectif est de retirer une page des résultats, choisissez une méthode correspondant à sa situation et vérifiez que le robot peut lire les directives nécessaires.
Puis-je bloquer les pages avec noindex dans robots.txt ?
Non. noindex n’est pas une directive standard de robots.txt reconnue par Google pour contrôler l’indexation. Pour qu’un moteur lise une balise ou un en-tête noindex, il doit pouvoir récupérer la page. En cas de doute, ne combinez pas blocage du crawl et demande de désindexation sans tester le scénario.
Est-ce utile de bloquer une page de connexion ou un panier ?
Cela dépend de la page et de son fonctionnement. Une page personnelle doit être protégée par une authentification, pas par robots.txt. Une page de panier peut être peu utile dans les résultats, mais vérifiez qu’une règle ne bloque pas aussi des URL ou ressources nécessaires au reste du site. Le blocage ne remplace ni la gestion des accès ni une stratégie d’indexation.
À quelle fréquence faut-il revoir le fichier ?
Revoir le fichier lors d’une refonte, d’un changement de CMS, d’une migration de domaine ou d’une évolution importante de l’architecture est une bonne pratique. Pour un site stable, un contrôle périodique et un test après toute modification suffisent souvent. La fréquence dépend du rythme de publication et de la complexité des URLs.
Sources recommandées
À retenir
robots.txt sert à guider le crawl, pas à sécuriser des données ni à garantir la désindexation. Écrivez des règles ciblées, vérifiez leur effet sur les URL et ressources importantes, testez le fichier réellement publié et contrôlez de nouveau après chaque changement majeur.
Pour aller plus loin